OpenAI indica una lettura della cache a 0,10 dollari per milione di token. Questa tariffa interessa le attività ricorrenti, a patto di verificarne la qualità reale.
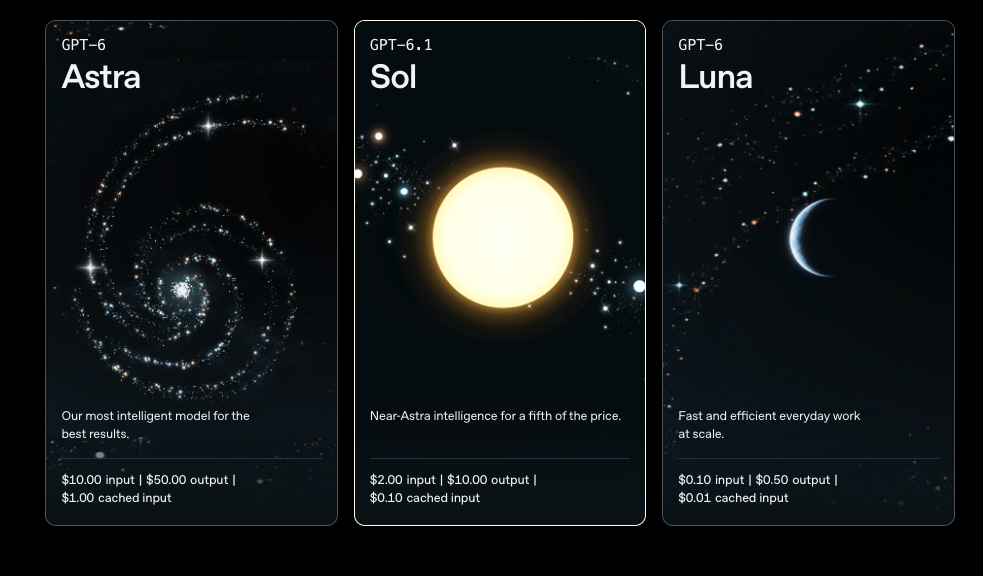
Un dossier di riferimento può essere riletto a ogni nuova richiesta rivolta a un modello. Nel listino di GPT-6.1 Sol, OpenAI fattura gli input in cache a 0,10 dollari per milione di token, contro 2 dollari per gli input standard. L’output costa 10 dollari per milione. I prezzi standard di input e di output rappresentano un quinto di quelli di GPT-6 Astra; questo rapporto non garantisce una fattura complessiva divisa per cinque.
La pagina di lancio presenta il modello come un’evoluzione di GPT-6 Sol, accessibile in Work, Codex e nell’API. Riporta progressi in diverse valutazioni di lavoro professionale, precisando al tempo stesso che le prove in ambiente di ricerca o tramite API possono differire dall’uso in produzione. Questa riserva accompagna i confronti di prestazioni.
Conservare un contesto che merita di essere conservato
Per un team editoriale o una direzione di collezione, il riutilizzo potrebbe riguardare un corpus di riferimenti approvato. Resta però da sapere quale versione della linea guida, del catalogo o del brief sia ancora pertinente. Una lettura meno costosa di un’istruzione superata non produce alcun risparmio utile.
La valutazione dovrebbe dunque associare due controlli: la qualità delle risposte e la validità del contesto riutilizzato. Un dossier corretto dopo ogni errore permetterebbe di vedere se il miglioramento si trasmette ai lavori successivi. Le correzioni umane, le nuove richieste e il tempo di revisione rientrerebbero nel costo complessivo.
Il prezzo della cache fornisce un parametro d’acquisto preciso. La decisione di affidarle più lavoro dipende da un’altra prova: la capacità di conservare i riferimenti giusti senza propagare i vecchi errori. Questa prova va prodotta sui documenti e sulle esigenze del team.
Cette publication est également disponible en :


