11

OpenAI 将缓存读取定价为每百万 token 0.10 美元。这一价格对重复性任务有吸引力,前提是核实其实际质量。
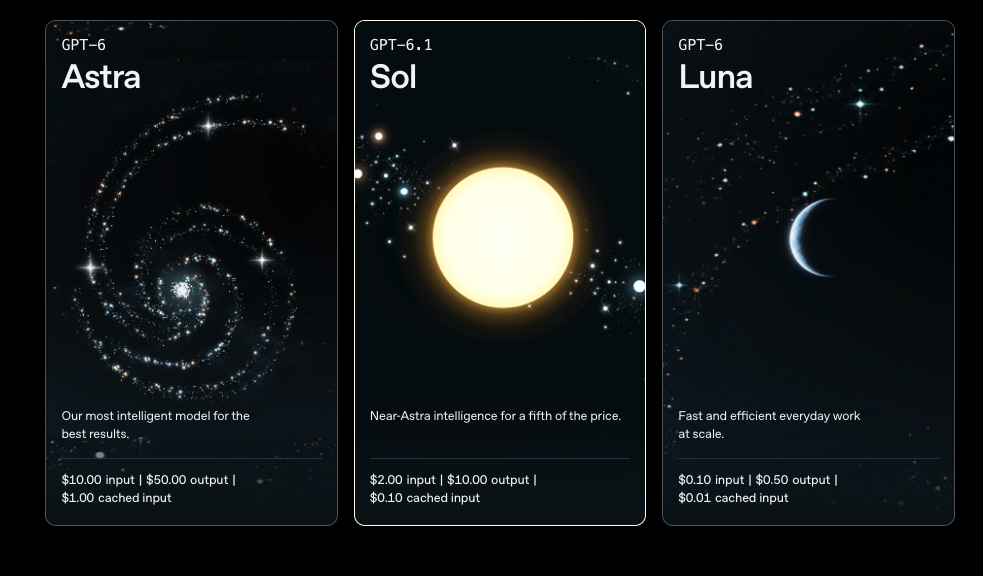
一份参考文件可以在向模型发出的每次新请求中被重新读取。在 GPT-6.1 Sol 的定价中,OpenAI 对已缓存的输入按每百万 token 0.10 美元计费,标准输入则为 2 美元。输出为每百万 10 美元。标准输入与输出价格均为 GPT-6 Astra 的五分之一;这一比例并不保证总账单也会缩减为五分之一。
发布页面将该模型介绍为 GPT-6 Sol 的演进版本,可在 Work、Codex 和 API 中使用。页面报告了若干专业工作评估上的进步,同时说明在研究环境或通过 API 进行的测试,可能与生产环境中的使用有所不同。这一保留意见伴随着各项性能比较。
保留值得保留的上下文
对编辑团队或系列负责部门而言,复用可以涉及一套经批准的参考语料。但仍须弄清,品牌规范、产品目录或工作简报的哪个版本依然适用。以更低成本读取一条过时的指令,并不会带来任何有用的节省。
因此,评估应结合两项检查:回答的质量,以及被复用上下文的有效性。若每次出错后都修正文件,就能看出改进是否会传递到后续工作。人工修正、追问和审阅时间都应计入完整成本。
缓存价格提供了一个精确的采购参数。是否把更多工作交给它,取决于另一种证据:能否保留正确的参考资料,而不把旧错误传播下去。这一证据必须在团队自己的文件和要求上产生。
Cette publication est également disponible en :


